چگونه هوش مصنوعی را به اطلاعات شرکت متصل کنیم؟
از انتخاب منبع معتبر و کنترل دسترسی تا جستوجو، ارجاع و ارزیابی پاسخ؛ مسیر عملی ساخت یک دستیار متصل به دانش واقعی سازمان.

در این مقاله
- اول مشخص کنیم هوش مصنوعی قرار است چه کاری انجام دهد
- دادهها در چه وضعیاند؟
- سه روش اتصال که نباید با هم اشتباه شوند
- جستوجو و پاسخ براساس اسناد
- پرسوجوی داده ساختاریافته
- اقدام در سیستم
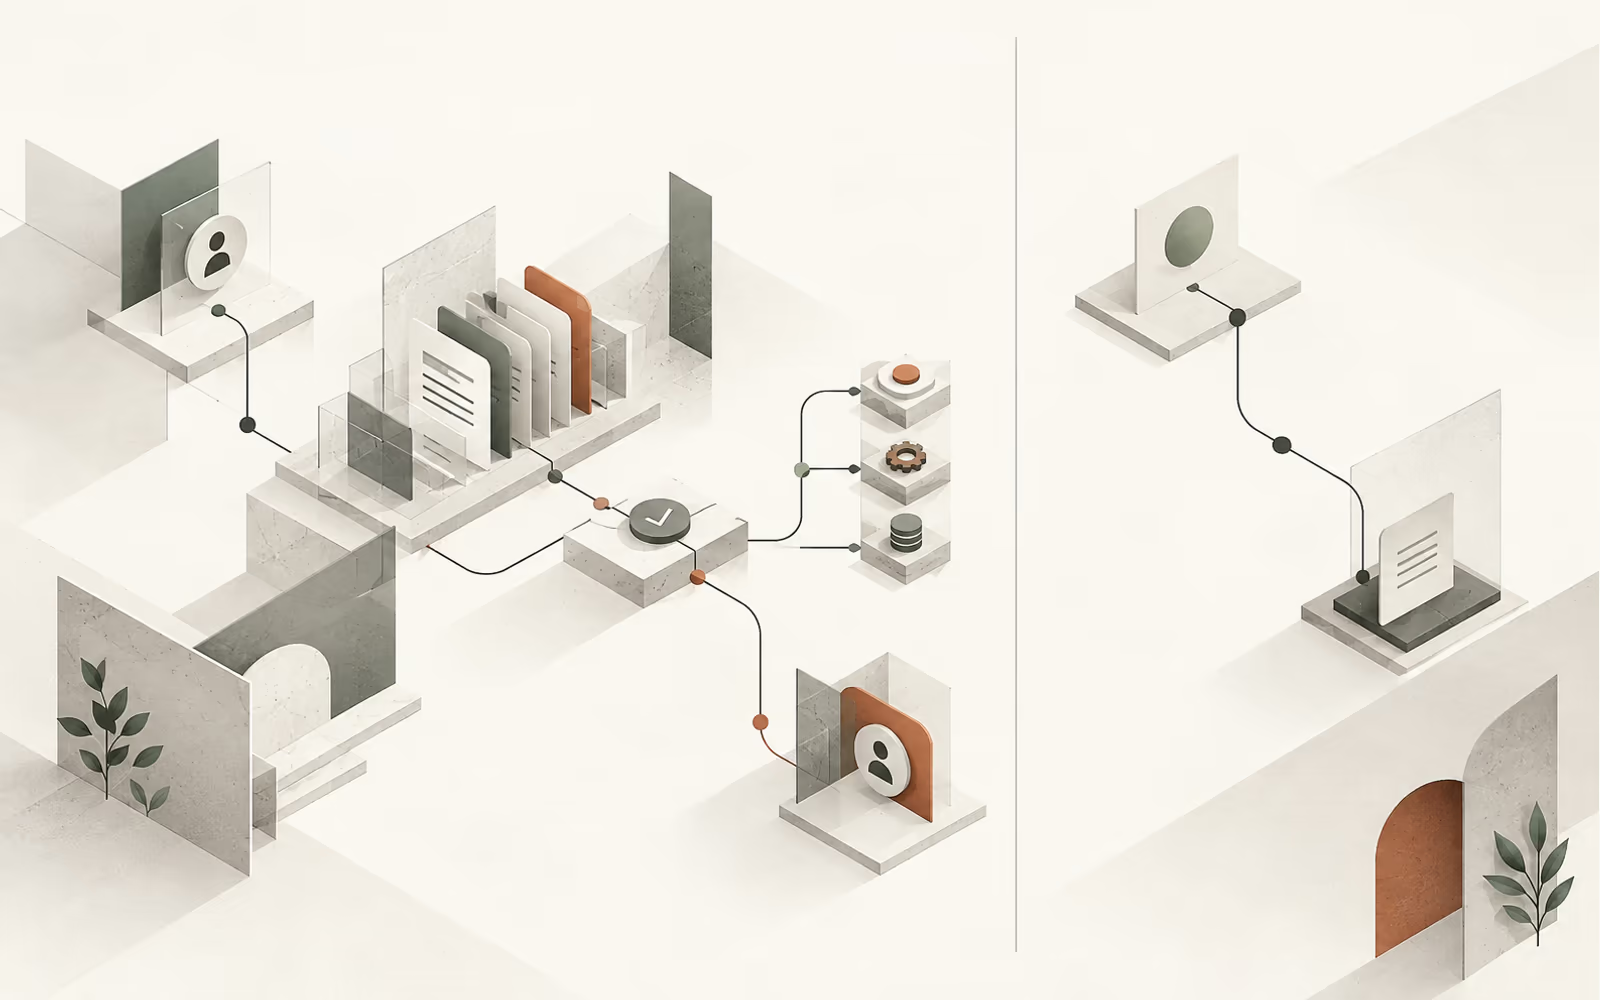
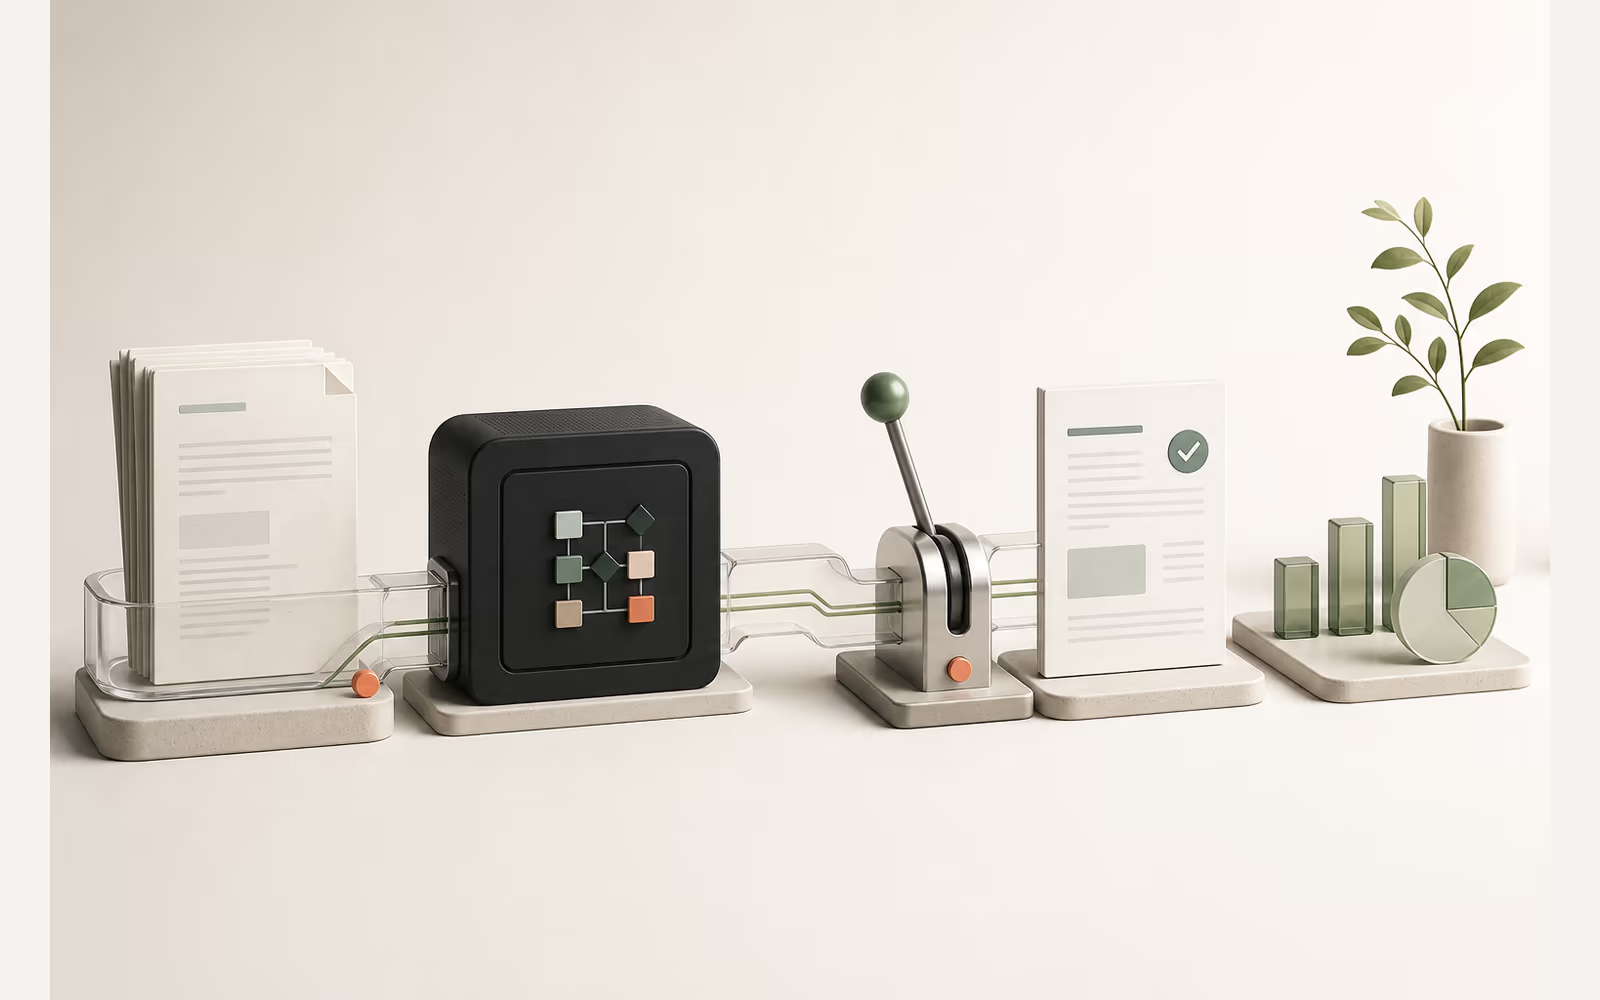
- یک معماری قابلفهم برای دستیار سازمانی
- دسترسی باید قبل از پاسخ کنترل شود
- مسئله زبان فارسی و اسناد واقعی
- چطور از پاسخ اشتباه و افشای اطلاعات جلوگیری کنیم؟
- یک نمونه عملی: دستیار پاسخگویی داخلی
- آزمون کیفیت را چگونه طراحی کنیم؟
- نسخه اولیه را از کجا شروع کنیم؟
- پرسشهای پرتکرار
- آیا برای اتصال داده باید مدل را دوباره آموزش داد؟
- آیا میتوان همه فایلهای شرکت را یکجا متصل کرد؟
- اگر اطلاعاتی در اسناد نبود، چه میشود؟
- جمعبندی
برای اینکه هوش مصنوعی به پرسشهای مربوط به شرکت شما پاسخ بدهد، کافی نیست چند فایل را در یک چت بارگذاری کنیم. نخست باید روشن شود اطلاعات معتبر کجاست، چه کسی اجازه دیدن هر بخش را دارد، دادهها چقدر تازهاند و پاسخ اشتباه چه پیامدی دارد. بعد میتوان روش فنی مناسب را انتخاب کرد.
در بسیاری از کاربردها، یک لایه جستوجو اطلاعات مرتبط را از منابع مجاز پیدا میکند و مدل زبانی با تکیه بر همان اطلاعات پاسخ میسازد. این الگو معمولاً «تولید تقویتشده با بازیابی» یا RAG نامیده میشود. اما RAG بهتنهایی مشکل داده ناقص، دسترسی اشتباه یا پاسخ ساختگی را حل نمیکند. در این راهنما مسیر عملی اتصال را از پرسش کسبوکار تا آزمون و نگهداری مرور میکنیم.
اول مشخص کنیم هوش مصنوعی قرار است چه کاری انجام دهد
«هوش مصنوعی را به دادهها وصل کنیم» هنوز یک نیاز قابل اجرا نیست. شاید کارشناس پشتیبانی میخواهد پاسخ یک پرسش را در آییننامه پیدا کند؛ شاید فروشنده میخواهد مشخصات محصول مناسب را مقایسه کند؛ شاید مدیر میخواهد گزارشی از سفارشها بگیرد. هرکدام به داده، سطح دسترسی و معیار کیفیت متفاوتی نیاز دارد.
برای شروع، یک جمله عملی بنویسید: «کاربرِ مشخص، در موقعیت مشخص، میخواهد با کمک اطلاعات مشخص به نتیجه مشخص برسد.» سپس چند پرسش واقعی و پاسخ پذیرفتنی جمع کنید. همین نمونهها بعداً مجموعه آزمون سیستم میشوند.
دادهها در چه وضعیاند؟
منابع سازمانی معمولاً ترکیبی از فایل، پایگاه داده، صفحه راهنما، تیکت، ایمیل و دانش شفاهی کارکناناند. پیش از هر انتخاب فنی، برای هر منبع این موارد را ثبت کنید:
- مالک و مسئول بهروزرسانی آن کیست؟
- آخرین نسخه معتبر کجاست و نسخههای قدیمی چگونه مشخص میشوند؟
- چه گروههایی مجاز به دیدن آن هستند؟
- آیا اطلاعات شخصی، قراردادی یا محرمانه در آن وجود دارد؟
- با چه سرعتی تغییر میکند و چه زمانی باید در پاسخها تازه شود؟
اگر پاسخ چند سند با هم تناقض دارد، مدل نباید از روی آنها یک «حقیقت» تازه بسازد. این تعارض باید در منبع حل شود یا در پاسخ بهروشنی دیده شود. هوش مصنوعی کیفیت مدیریت اطلاعات را جایگزین نمیکند؛ آن را آشکارتر میکند.
سه روش اتصال که نباید با هم اشتباه شوند
جستوجو و پاسخ براساس اسناد
برای پرسشهایی مانند «سیاست مرجوعی چیست؟» یا «مراحل ثبت درخواست کداماند؟»، سیستم میتواند بخشهای مرتبط از اسناد را بازیابی کند و همراه با ارجاع پاسخ بدهد. سند اصلی باید قابل بازکردن باشد تا کاربر بتواند پاسخ را بررسی کند. مستندات Microsoft درباره RAG نیز بر ارزیابی کیفیت بازیابی و ارجاع پاسخ تأکید دارد.
پرسوجوی داده ساختاریافته
برای موجودی، وضعیت سفارش یا گزارش فروش، اسناد متنی منبع خوبی نیستند. داده باید از سامانه معتبر و با قواعد مشخص خوانده شود. مدل میتواند سؤال طبیعی کاربر را به یک درخواست محدود تبدیل کند، اما مجوز، فیلترها، محاسبه و اعتبارسنجی نتیجه باید در منطق نرمافزار انجام شود. پاسخ «موجودی امروز» نباید از یک فایل PDF قدیمی بیرون بیاید.
اقدام در سیستم
ثبت تیکت یا ایجاد پیشنویس پاسخ، با خواندن اطلاعات فرق دارد. برای اقدام، باید مجوز مستقل، ثبت رویداد و در کارهای حساس تأیید انسانی وجود داشته باشد. بهتر است نسخه نخست فقط بخواند و پیشنهاد بدهد؛ اختیار نوشتن یا تغییر داده بعد از آزمون رفتار واقعی اضافه شود.
یک معماری قابلفهم برای دستیار سازمانی
- ورود داده: اتصال به منابع تأییدشده، ثبت مالک، نسخه و زمان آخرین تغییر.
- آمادهسازی: استخراج متن، حذف تکرار و بخشبندی همراه با عنوان و ارجاع به منبع.
- کنترل دسترسی: حفظ مجوز هر سند یا رکورد و اعمال آن هنگام جستوجوی هر کاربر.
- بازیابی: یافتن بخشهای واقعاً مرتبط با پرسش، با ترکیب جستوجوی واژگانی و معنایی در صورت نیاز.
- ساخت پاسخ: ارائه پاسخ کوتاه بر پایه یافتهها، همراه با منبع و اعلام ابهام در نبود شواهد کافی.
- ارزیابی و پایش: بازبینی نمونه پرسشها، خطاها، زمان پاسخ و تغییرات منابع.
این معماری یک نسخه ثابت برای همه سازمانها نیست. اگر پرسشها محدود و پاسخها کاملاً مشخصاند، یک جستوجوی خوب یا گردشکار قاعدهمحور ممکن است سادهتر و قابلاعتمادتر باشد.
دسترسی باید قبل از پاسخ کنترل شود
تصور کنید دو کارمند درباره قرارداد یک مشتری سؤال یکسانی میپرسند، اما فقط یکی از آنها مجوز دیدن قرارداد را دارد. پنهانکردن نام فایل در رابط کافی نیست. سیستم باید پیش از دادن متن به مدل، نتایج جستوجو را براساس هویت و مجوز همان کاربر محدود کند. راهنمای امنیت Azure AI Search نیز کنترل دسترسی در سطح سند و اعمال آن هنگام پرسوجو را از اصول مهم سامانههای متصل به دانش سازمانی میداند.
همچنین باید روشن شود چه دادهای برای پردازش به کدام سرویس فرستاده میشود، چه مدت نگه میماند و چه کسی به تاریخچه پرسشها دسترسی دارد. این تصمیمها قراردادی و فنیاند و باید قبل از اتصال داده محرمانه گرفته شوند.
مسئله زبان فارسی و اسناد واقعی
اطلاعات فارسی همیشه تمیز و یکدست نیست. «ی» و «ک» عربی و فارسی، نیمفاصله، اصطلاحهای متفاوت برای یک محصول، جدولهای درون PDF و اسکنهای کمکیفیت میتوانند بازیابی را ضعیف کنند. گاهی یک سند ظاهراً وارد سیستم شده، اما بخش مهم آن اصلاً به متن قابل جستوجو تبدیل نشده است.
به همین دلیل، نمونهبرداری از اسناد واقعی ضروری است. چند پرسش را با واژههای معمول کارکنان مطرح کنید و ببینید آیا بخش درست پیدا میشود؛ نه اینکه فقط روانی پاسخ مدل را بسنجید. برای کاتالوگ محصول، علاوه بر متن، ویژگیهای ساختاریافته مانند اندازه، موجودی و سازگاری نیز لازماند. راهنمای دستیار هوشمند انتخاب محصول همین تفاوت را با جزئیات بیشتری توضیح میدهد.
چطور از پاسخ اشتباه و افشای اطلاعات جلوگیری کنیم؟
مدل زبانی ممکن است با اطمینان، پاسخی بسازد که در منبع وجود ندارد. سند بازیابیشده نیز میتواند متن مخربی داشته باشد که بخواهد رفتار مدل را تغییر دهد. راهنمای OWASP درباره تزریق دستور توضیح میدهد که حتی استفاده از RAG این خطر را بهطور کامل از بین نمیبرد.
- متن سند را «داده» بدانید، نه دستور قابل اجرا برای سیستم.
- ابزارهای متصل را به کمترین مجوز لازم محدود کنید.
- برای پاسخهای حساس، منبع قابل بررسی و مسیر ارجاع به انسان فراهم کنید.
- در نبود شاهد کافی، پاسخ «اطلاعات کافی ندارم» را مجاز بدانید.
- برای تغییر داده یا انجام عملیات مهم، تأیید و ثبت رویداد مستقل داشته باشید.
- با پرسشهای گمراهکننده، اسناد متناقض و تلاش برای عبور از دسترسی آزمون کنید.
یک نمونه عملی: دستیار پاسخگویی داخلی
فرض کنیم تیم پشتیبانی، پرسشهای تکراری درباره شرایط خدمات، مراحل رسیدگی و مشخصات محصول دریافت میکند. اطلاعات در چند فایل و صفحه داخلی پراکنده است. نسخه آزمایشی میتواند فقط به همان منابع تأییدشده متصل شود، پاسخ پیشنهادی را همراه با لینک سند به کارشناس نشان دهد و ارسال نهایی را به خود او بسپارد.
در این حالت، معیارهای اولیه «درستی منبع»، «پوشش پرسشهای پرتکرار» و «زمان یافتن پاسخ» هستند. اگر سیستم در یافتن سند معتبر ضعیف است، بازنویسی پرامپت بهتنهایی کافی نیست؛ باید کیفیت داده، بخشبندی یا جستوجو اصلاح شود. این مثال یک الگوی فرضی است، نه ادعای نتیجه برای یک مشتری نوبین.
آزمون کیفیت را چگونه طراحی کنیم؟
پیش از ساخت، مجموعهای از پرسشهای واقعی فراهم کنید: سؤال مستقیم، مبهم، چندبخشی، بدون پاسخ، متناقض و خارج از سطح دسترسی. برای هرکدام بنویسید پاسخ قابلقبول چیست و از کدام منبع باید بیاید. بعد کیفیت را در دو مرحله جدا ببینید:
- بازیابی: آیا سند درست و مجاز پیدا شد؟
- پاسخ: آیا پاسخ با سند سازگار، کوتاه، قابل پیگیری و بدون ادعای اضافه است؟
امتیازدهی صرف به «خوببودن لحن» گمراهکننده است. یک پاسخ خوشخوان اما غلط، مشکل کسبوکار را بیشتر میکند. خطاهای مهم را برحسب شدت جدا کنید؛ اشتباه در یک توضیح عمومی با افشای سند محرمانه هموزن نیست.
نسخه اولیه را از کجا شروع کنیم؟
یک گروه کاربر، یک نوع پرسش و یک مجموعه سند محدود انتخاب کنید. ابتدا کیفیت و مجوز منابع را بررسی کنید. سپس نمونهای بسازید که پاسخ را با ارجاع نشان دهد و در موارد مبهم سکوت کند. آن را با پرسشهای واقعی و زیر نظر کارکنان آزمایش کنید. تنها بعد از دیدن خطاها درباره گسترش دامنه تصمیم بگیرید.
اگر پروژه همزمان به چند سامانه، داده زنده و عملیات اجرایی نیاز دارد، مسیر را به فازهای جدا تقسیم کنید. مقاله خودکارسازی فرایندها با هوش مصنوعی نشان میدهد چه زمانی بهتر است از پاسخگویی فراتر برویم.
پرسشهای پرتکرار
آیا برای اتصال داده باید مدل را دوباره آموزش داد؟
در بسیاری از کاربردهای پرسش و پاسخ، خیر. بازیابی اطلاعات معتبر و افزودن آن به زمینه پاسخ، نقطه شروع مناسبتری است. آموزش یا تنظیم مدل برای بعضی الگوهای رفتاری مفید است، اما جای داده تازه و کنترل دسترسی را نمیگیرد.
آیا میتوان همه فایلهای شرکت را یکجا متصل کرد؟
از نظر فنی شاید؛ از نظر کیفیت و امنیت معمولاً شروع خوبی نیست. نسخهها، مالکیت، مجوز و تعارض اسناد باید بررسی شوند. یک دامنه کوچک و معتبر امکان آزمون واقعی میدهد.
اگر اطلاعاتی در اسناد نبود، چه میشود؟
سیستم باید نبود منبع کافی را اعلام کند، سؤال تکمیلی بپرسد یا کاربر را به مسئول مربوط ارجاع دهد. ساختن پاسخ از روی حدس، اعتماد به سامانه را از بین میبرد.
جمعبندی
اتصال هوش مصنوعی به اطلاعات شرکت، پروژهای درباره داده، دسترسی و کیفیت پاسخ است. از یک نیاز محدود شروع کنید، منبع معتبر و مجوزها را روشن کنید، بازیابی و پاسخ را جداگانه بسنجید و برای خطاهای حساس مسیر انسانی داشته باشید. وقتی این پایه درست کار کند، افزودن منابع و قابلیتهای بیشتر تصمیمی آگاهانه خواهد بود.
برای بررسی یک کاربرد مشخص در سازمان خود میتوانید مسیر راهکارهای هوش مصنوعی نوبین را ببینید و مسئله و منابع اطلاعاتیتان را توضیح دهید.